实验汇总与可引用结果
本章按实验所回答的问题合并结果。同一表内采用统一指标和 selector;训练协议发生变化时另列实验组。下列百分数中的 ± 是独立训练 seed 均值的样本标准差,单位为百分点;各训练 seed 内的评估场景数另行说明。所有聚合由 collect_evidence.py 从结果文件重建,逐 seed 数值、来源路径和源文件 SHA-256 均已保存。来源清单
评估协议与阅读方式
E01、E02、E04 的正式训练对照与 E05 使用 DelivCoal 的 12 机器人、10 配送任务、750 步、sector coverage、event 日程。训练上限 1500 episodes,配置名义预算 1,125,000 环境步;实际交互步数随回合提前结束而变化。周期验证使用固定 32 场景;validation-best 在验证结果中按成功率、完成率、回合长度、checkpoint 先后顺序锁定,然后执行 128 场景留出测试。last 对应末次训练权重。正式测试种子从 50000 开始,验证种子从 10000 开始。逐 seed 和配置表提供每个实验的确切设置。正式结果、研究参数
E08、E09、E12 的历史 best/p90/last 保留当时的 selector 名称;p90 是指定位置的 checkpoint。它们在各自实验内比较。E06 在同一策略产生的事件前状态上配对干预;不同策略会产生不同状态。E10、E11 的官方环境与适配环境分别统计。
E01 联盟上下文与相同 PPO 框架下的整体效果
问题:按配送任务汇总联盟成员的信息,是否有助于完成当前配送环境?五个训练 seed 的固定条件对照如下,指标为 episode 全部完成成功率。
| 条件 | 训练 seed 数 | validation-best | last |
|---|---|---|---|
| HATT v2.0 full | 5 | 72.19% ± 5.76 | 65.16% ± 6.02 |
| 去 AA | 5 | 69.22% ± 3.93 | 69.22% ± 4.61 |
| 去 coalition context | 5 | 61.88% ± 10.89 | 57.66% ± 9.65 |
| MAPPO288 | 5 | 22.81% ± 6.45 | 5.94% ± 5.02 |
| MAPPO64 | 5 | 10.16% ± 6.25 | 1.09% ± 0.89 |
完整 v2.0 的任务完成率为 96.44%,去联盟上下文为 94.80%;成功率差为 10.31 个百分点。这组对照为任务上的联盟汇总提供了效果依据。MAPPO288 将 actor 参数量提高到接近 v2.0 的规模,提供相同 PPO 框架下的加宽对照。五 seed 汇总、架构与参数
末期轨迹另用最后 10% 的逐 episode actor、每个 actor 8 个场景评估,先在每个训练 seed 内平均,再跨 seed 汇总。full 为 75.50%,no-AA 为 76.48%,no-coalition 为 58.87%,MAPPO288 为 5.07%,MAPPO64 为 3.72%。这项统计描绘末期权重轨迹;其场景种子从 30000 开始,主表采用独立的 128 场景测试。末期逐 seed、末期聚合
E02 探索历史与几何输入的作用
问题:探索候选中的覆盖历史,怎样影响发现和完成任务?下表统一取训练 seed 1–3,比较成功率。geometry-only 保留探索候选相对几何,coverage 条件另外提供覆盖历史摘要;no-coverage 使用对应关闭覆盖输入的设置。
| 条件 | 训练 seed 数 | validation-best | last |
|---|---|---|---|
| HATT coverage | 3 | 70.83% ± 7.71 | 65.89% ± 8.35 |
| HATT geometry-only | 3 | 31.51% ± 1.97 | 27.60% ± 4.01 |
| HATT no-coverage | 3 | 33.85% ± 5.86 | 19.27% ± 11.06 |
| MAPPO64 coverage | 3 | 8.33% ± 6.31 | 1.30% ± 1.19 |
| MAPPO64 geometry-only | 3 | 17.45% ± 7.83 | 2.86% ± 2.26 |
完整输入 HATT 的任务发现率为 96.98%,geometry-only 为 89.95%,no-coverage 为 87.24%;相应任务完成率为 96.07%、88.33%、85.63%。在这组场景中,覆盖输入同时对应较高的发现比例和完成比例。这一结果支持将覆盖图摘要写入环境信息条件,并在联盟机制实验中单独记录任务是否已发现。统一三 seed 结果、配置差异
E03 任务 ID 重排的一致性
问题:重新编号相同物理任务时,冻结策略的闭环行为是否保持对应?实验同步重排任务槽、动作和联盟编号,分别测试 Deliver 槽与 Explore 槽,使用历史 coverage-event 模型、每种模型 3 个训练 seed、各 128 个场景。
HATT 在两种重排中都保持原成功率:三个 seed 为 71.09%、78.13%、60.16%,均值 69.79%;每组 384 个配对回合的成功/失败标记均保持一致。Explore 重排下,MAPPO 均值从 14.58% 变为 2.60%。这里的直接证据是任务重编号下的行为一致性;方法章给出相应计算图推导,v3.4 单元检查覆盖任务/智能体排列与合法动作掩码。Deliver 配对、Explore 配对、结构检查
E04 可学习 AA 权重及冻结策略的消息干预
第一组问题是训练时的成员加权方式。learned 与 uniform-trained 各独立训练三个 seed,保持其余设置一致。
| 条件 | 训练 seed 数 | validation-best | last |
|---|---|---|---|
| learned | 3 | 62.50% ± 10.16 | 62.50% ± 10.16 |
| uniform-trained | 3 | 54.17% ± 8.88 | 54.69% ± 9.01 |
learned 的所选 checkpoint 任务完成率为 95.00%,uniform-trained 为 93.36%,为学习 AA 加权提供了该训练方案下的效果记录。训练对照
第二组固定 learned checkpoint,在推理时改动 AA 消息。相同 128 场景上,learned、uniform-at-inference、zero-at-inference 的三 seed 平均成功率分别为 62.50%、55.21%、67.45%。zero 条件获得了本组最高均值,记录了消息强度调整对现成策略的影响。两组实验分别回答“怎样训练”和“冻结策略怎样依赖当前消息”,分析时保留各自干预定义。冻结干预逐 seed
这些结果用于组织 v3.3AA/v3.4 的论文依据:成员加权可通过回报学习,其实际作用需要结合候选路由与行为结果观察。E06 进一步记录 AA 置零条件对突发任务的响应。
E05 v3.4 服务任务上下文的同期训练对照
问题:AA 关系读取邻居当前服务任务的四维摘要后,训练结果怎样变化?taskctx 与 noctx 各三个训练 seed,全部完成 1500 episodes。六个训练任务共有 180 次周期验证、12 次最终测试,合计 7296 次评估回合。taskctx 的服务摘要使 AA 边输入由 3 维变为 7 维,增加 512 个参数。代码和输入定义
| 条件 | 训练 seed 数 | validation-best | last |
|---|---|---|---|
| v3.4 taskctx | 3 | 65.10% ± 7.51 | 61.72% ± 4.69 |
| v3.4 noctx | 3 | 62.50% ± 10.16 | 62.50% ± 10.16 |
| selector | taskctx 任务完成率 | noctx 任务完成率 | taskctx 平均长度 | noctx 平均长度 |
|---|---|---|---|---|
| validation-best | 95.31% | 95.00% | 649.79 | 658.77 |
| last | 94.48% | 94.97% | 657.85 | 660.00 |
| 训练 seed | taskctx 所选 episode | noctx 所选 episode | taskctx 成功回合 /128 | noctx 成功回合 /128 |
|---|---|---|---|---|
| 1 | 850 | 1500 | 85 | 80 |
| 2 | 700 | 1400 | 92 | 93 |
| 3 | 1500 | 1500 | 73 | 67 |
这轮记录到 validation-best 成功率均值增加 2.60 个百分点,跨训练 seed 标准差分别为 7.51 和 10.16 个百分点。last 的完整结果同时列出,供后续按统一选模协议引用。v3.4 noctx 的本轮汇总数值与历史 v3.3AA learned 对应结果一致,在汇总研究证据时将它们视作同一参考表现。逐 seed、统一三 seed
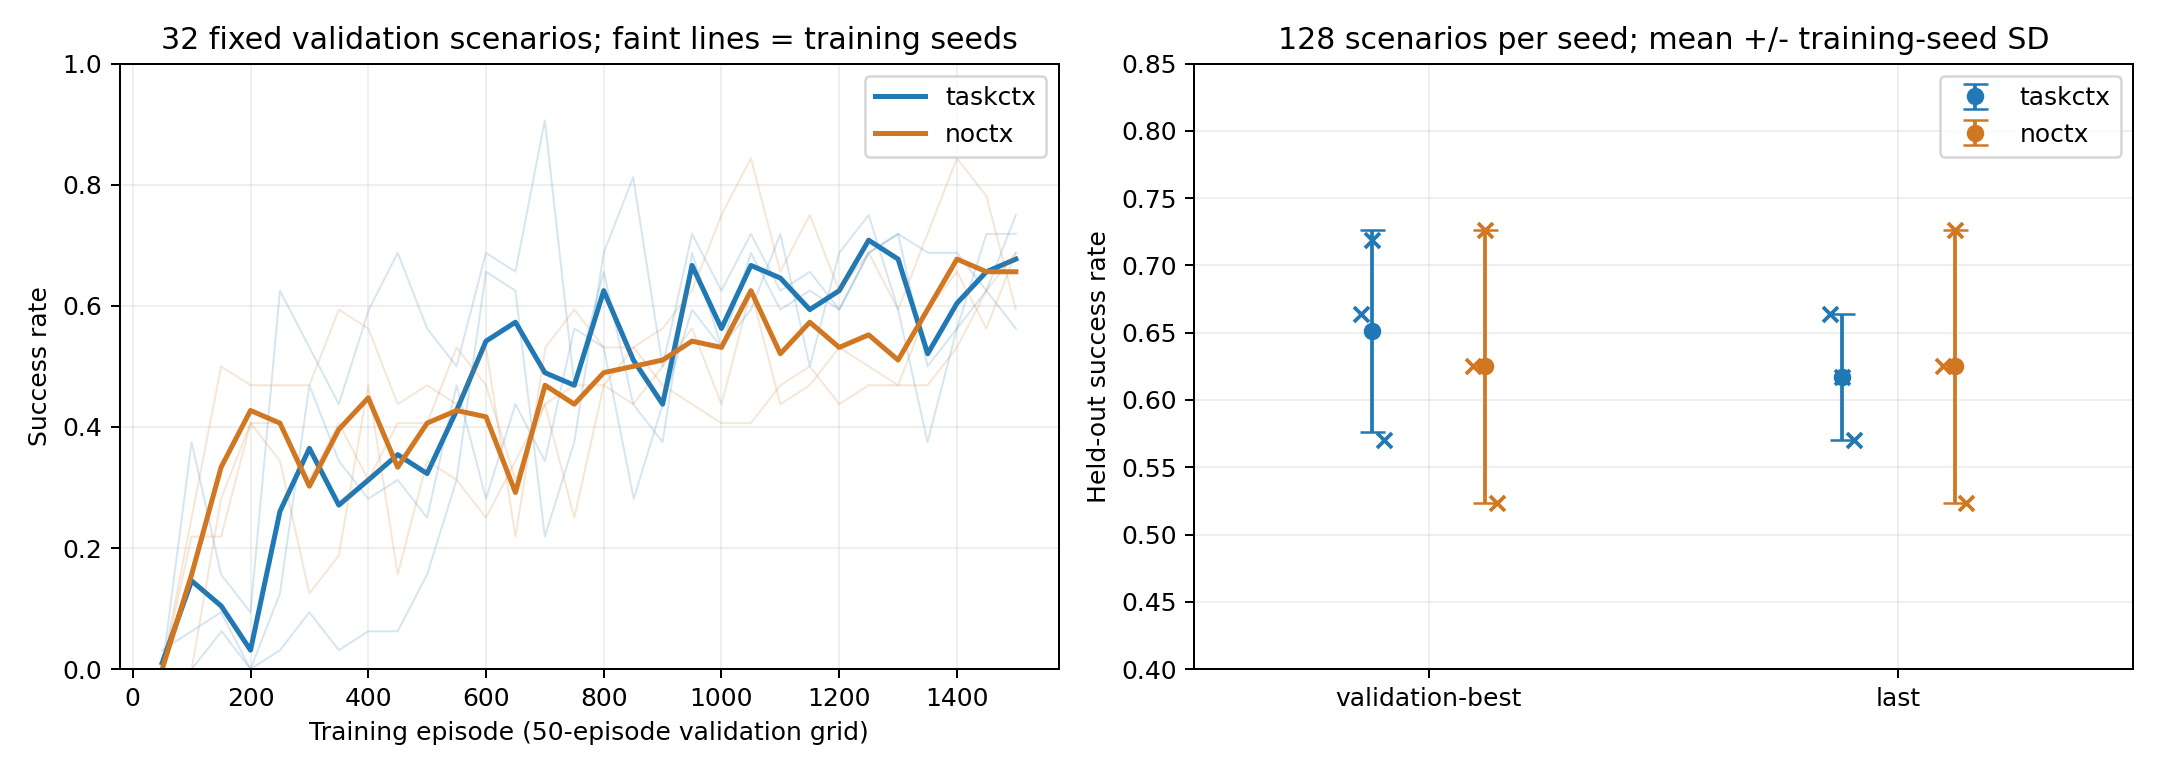
图中横轴使用 training episode。个别周期点在 rollout 结束时落于计划阈值后一回合,原始点保留实际 episode。各 seed 的 validation-best 已在测试前锁定;selected 与 last 恰好相同时,对应测试属于相同权重的重复评价。周期点、选模记录
为连接历史对照,下表统一取训练 seed 1–3,仅展示相同主要训练和测试协议下的成功率。它给出 v3.4 在已有研究环境中的位置。
| 条件 | 训练 seed 数 | validation-best | last |
|---|---|---|---|
| v3.4 taskctx | 3 | 65.10% ± 7.51 | 61.72% ± 4.69 |
| v3.4 noctx | 3 | 62.50% ± 10.16 | 62.50% ± 10.16 |
| v2.0 full | 3 | 70.83% ± 7.71 | 65.89% ± 8.35 |
| MAPPO288 | 3 | 27.08% ± 3.52 | 4.17% ± 2.96 |
| MAPPO64 | 3 | 8.33% ± 6.31 | 1.30% ± 1.19 |
E06 突发高优先级任务与联盟重组
问题:冻结模型如何响应同一任务价值的变化,重选怎样影响源任务与目标任务?实验覆盖五个条件、各三个训练 seed,每 seed 32 个配对场景;共 1440 条闭环轨迹、960 条配对效应记录。在同一模型、同一事件前状态下揭示相同任务,将 priority 设置为 1.0 或 0.5。另在高优先级条件下比较立即 react 和首次保持当前动作的 keep-current,之后继续原策略。评估实现、配对效应
| 条件 | high−low 任务概率 | 指派人数变化 | 首次响应步数变化 |
|---|---|---|---|
| v3.3AA learned | +0.0419 | +0.490 | −25.93 |
| v3.3AA uniform-trained | +0.0260 | +0.396 | −16.23 |
| v3.3AA learned,推理 AA 置零 | +0.0633 | +0.667 | −22.42 |
| v2.0 | +0.0881 | +1.333 | −58.55 |
| MAPPO64 | −0.0012 | 0.000 | +0.03 |
learned 的跨训练 seed 标准差分别为 0.0189、0.065 人和 11.82 步。HATT 条件呈现明确的优先级敏感响应:目标概率、初始分配和响应时刻共同发生变化。全部条件中的事件任务最终完成比例为 100%。这些观测分别刻画策略决策和事件任务后果。跨 seed 汇总
在高优先级的 react−keep-current 比较中,learned 平均首次响应提前 8.14 步;首次重选的 5.198 次归属变化中,2.250 次进入事件任务、2.948 次发生在其他任务之间,1.667 次为源联盟脆弱条件下的退出。最终任务完成率差为 0.00 个百分点,剩余需求差 +1.29,回报差 −1.91±13.73。该实验同时记录了目标响应和全队后果,给后续“源依赖程度 × 目标收益”配对提供了直接设计依据。同一效应表
high−low 的奖励目标随 priority 一起变化,适合分析价值敏感行为。react−keep-current 固定高优先级奖励目标,适合分析允许当次重选后的执行后果。不同方法的状态由各自策略产生,跨方法表格用于比较响应模式;同一物理状态上的方法比较按共享状态库协议执行,详见交接章。
E07 任务输入语义与尺度
问题:compact6 到 full12 的特征表达如何影响训练?这一系列使用各自固定协议,按桥接、尺度、函数保持初始化分为三个组。指标采用任务完成率。
桥接组在相同单 seed、1500 episodes、legacy 日程下,compact6 的 validation-best 完成率为 33.59%,full12 为 7.42%;同组 MAPPO 为 4.45% 和 1.56%。full12 同时改变字段位置和数值表达,后续实验把这些因素进一步显式控制。桥接结果
尺度组采用单 seed、1000 episodes,固定 full12 物理环境;native、恢复 req/priority 尺度、投影至 compact 的任务完成率如下。
| 条件 | 训练 seed 数 | validation-best | last |
|---|---|---|---|
| full12 native | 1 | 6.80% | 6.72% |
| full12 恢复尺度 | 1 | 15.47% | 17.58% |
| full12 compact 投影 | 1 | 25.08% | 26.02% |
恢复尺度在本组所选 checkpoint 上将完成率从 6.80% 提高到 15.47%;compact 投影为 25.08%。这组记录说明输入数值尺度和表达方式具有可测量的训练影响。研究设置
函数保持初始化组采用 3 个训练 seed、600 episodes、相同 full critic,配对初始化设置如下。
| 条件 | 训练 seed 数 | validation-best | last |
|---|---|---|---|
| compact 投影 | 3 | 6.72% ± 0.75 | 6.59% ± 0.59 |
| full12 函数保持初始化 | 3 | 6.30% ± 0.46 | 6.48% ± 0.21 |
| full12 默认初始化 | 3 | 6.54% ± 0.91 | 6.67% ± 0.16 |
三个条件的所选模型平均任务完成率落在 6.30%–6.72%,末次模型落在 6.48%–6.67%。代码测试检查 compact 投影、字段尺度恢复与函数保持初始化的对应关系,作为继续更换观测接口时的实现基准。初始化测试、本组逐 seed
E08 CapCoal 的独立训练迁移
问题:关系 actor 能否在另一组联盟环境设置中训练并完成任务?采用 30 机器人、25 任务、1500 步、nearest 探索、legacy 日程、random_demand 任务字段,各训练 3 个 seed、5000 episodes,再进行 128 场景旧 selector 评估。表格读取恢复后按 30/25/1500 执行的独立评估记录。
| 模型 | best 成功率 | p90 成功率 | last 成功率 | best 平均长度 | last 平均长度 |
|---|---|---|---|---|---|
| HATT v2.0 | 99.48% | 97.40% | 97.92% | 462.35 | 511.99 |
| MAPPO64 | 100.00% | 75.26% | 80.99% | 659.07 | 784.40 |
两种方法在各自 best 上完成了几乎全部场景;HATT 的平均回合长度为 462.35 步,末次模型成功率为 97.92%。这些结果提供另一套任务分布和执行日程下的训练迁移记录。任务初始隐藏,nearest 控制器读取最近未发现任务位置。训练预算、探索机制、奖励均以本组冻结记录为准。CapCoal 聚合、逐模型结果及元数据
E09 GymRT2A 空间任务环境
官方 MARL-MRT2A 在 20×20 网格、10 机器人、100 步动态回合、通信范围 8、视野范围 5、路径意图共享设置下完成 5 个 seed、各 300 万步训练。官方记录的最终平均 team return 为 655.824,跨训练 seed 样本标准差约 6.60。官方训练汇总
HATT 专用空间候选 actor 同样训练到 300 万步,使用两个训练 seed;每个 checkpoint 在 96 个留出场景测试,起始 seed 为 20000。best 的平均 team return 为 310.19,平均收集 L1/L2/L3 目标分别为 83.13、56.57、0.089;p90 与 latest 的回报均值为 283.65 和 268.27。这组结果提供 HATT 空间候选接口在原网格任务中的实际学习记录。HATT 留出表
官方训练日志指标与 HATT 独立留出评估保留各自采样协议。原环境包含等级任务、局部空间观测和路径意图;DelivCoal 中的任务概率与标量配送指标在这里分别映射为空间目标策略和等级收集指标。适配网络、环境接口
E10 外部方法的官方环境复现
CFM 官方 checkpoint 在 RALTestSet 的 50 个场景中,上游任务完成比例 success_rate 均值为 1.0,makespan 为 28.7448±3.1686,± 为场景标准差。该字段按完成任务数/任务总数计算。CFM 的小规模重新训练在固定 128 场景上,从 update 0 的任务完成比例 19.53%,提高到 update 50 的 98.83%,update 300 为 100%。官方结果、小规模学习、上游指标定义
MARL-MRT2A 的小规模重新训练使用 100 个固定评估回合,team return 从 1000 步的 54.5 提高到 301000 步的 384.3。两条记录共同提供外部代码在原任务上可训练、可评价的复现依据。学习结果
E11 外部方法与规则策略的 DelivCoal 适配
第一轮学习方法 screen 使用相同 150000 步预算、训练 seed 10、16 个评估场景。validation-best 的任务完成率:CFM greedy 为 2.50%,MARL-MRT2A 为 13.75%;last 分别为 3.13% 和 3.75%。此组保留了外部方法接入配送环境后的早期学习记录。适配结果及协议
后续采用各自明确的设置形成如下评价:
| 条件 | 训练预算 / seed | 测试 | 所选模型成功率 | 所选模型任务完成率 | 配送比例 |
|---|---|---|---|---|---|
| CFM-long,采样策略 | 375 updates×4 POMO,1500 episodes,名义 112.5 万步 / 10 | 128 场景 | 0.78% | 53.44% | 58.57% |
| MARL-MRT2A cap-lr | 15 万步 / 10 | 128 场景 | 0.00% | 21.25% | 44.68% |
| MARL-MRT2A cap-entropy | 15 万步 / 10 | 128 场景 | 0.00% | 21.25% | 45.69% |
| PCFA-DelivCoal | 确定性规则,无训练 | 128 回合 | 51.56% | 93.83% | 95.08% |
CFM-long 的所选与末次模型相同。MARL-MRT2A cap-lr 与 cap-entropy 的 last 任务完成率分别为 8.75% 和 12.50%。PCFA 平均回合长度为 665.45 步,128 回合由以 50000 初始化的 RNG 流顺序生成;其统计提供相同任务分布上的规则参照。学习方法的独立 seed 数、POMO 交互量、greedy/采样决策和状态信息分别保留于协议中。外部适配、PCFA 原始指标、规则执行
这些结果用于报告外部方法适配后的已测行为与配送水平。与主方法的正式横向比较表采用统一预算、信息字段和选模协议后填写,具体接口由 交接约定 固定。
E12 历史设计依据与值分解参照
以下选用每类同批次最具解释力的结果,全部沿用各自旧 best selector;每个数字的原始模型路径保存在逐 seed 表中。
| 实验主题 | 同组方法与 best 成功率 | 训练 seed 数 | 直接观察 |
|---|---|---|---|
| 特殊动作关系语义 | detached HATT 87.24%,原 HATT notimeout 29.95%,MAPPO notimeout 91.15% | 各 3 | detached 方案在该日程下完成了 87.24% 场景,为控制槽与配送成员分开处理提供依据 |
| 覆盖历史与 recurrence | HATT coverage 74.48%,coverage+RNN 70.31%,RNN 24.22%,MAPPO coverage 4.43% | 各 3 | coverage 条件在该批次形成较高完成水平,支持将探索历史作为显式观测 |
| 值分解 | QMIX、VDN、HATT-QMIX 的任务完成率为 25.67%、26.63%、18.44% | 各 5 | 三种值分解路径均产生部分任务交付与完成,提供同批值学习参照 |
QMIX/VDN 组采用团队均值奖励、recurrent individual-Q 和各自 mixer;与 PPO 主表的奖励信用与更新方式一起作为协议字段保留。历史聚合、逐 seed、QMIX trainer
论文证据的对应关系
| 论文表述的对象 | 可以直接引用的已测内容 | 证据 |
|---|---|---|
| 任务上的联盟信息组织 | 完整/去联盟上下文的同协议训练结果 | E01 |
| 输入与任务编号的一致性 | Deliver/Explore 槽配对重排、v3.4 结构测试 | E03 |
| 关系权重与服务任务条件 | learned/uniform 训练;taskctx/noctx 同期训练;冻结消息干预 | E04、E05 |
| 动态任务价值响应 | 同事件前状态下的概率、成员数与响应时间变化 | E06 |
| 环境信息的实际作用 | 覆盖历史、输入尺度和函数保持初始化的受控结果 | E02、E07 |
| 方法适配与任务差异 | CapCoal 独立训练、GymRT2A 空间候选、外部方法官方及配送适配 | E08–E11 |
每项论文判断应与表中对象保持同一范围。源联盟可替代性与重组全队收益的已定验证方案,作为下一轮研究交接记录于 07_handoff。